把PostgreSQL搬上新VPS时,数据目录只占半块盘,也可能在一次归档中断后耗尽空间。采购SpartanHost这类服务器前,需要给写前日志单独做一份故障预算:远端暂时收不到日志,本机能撑到什么时候;连接恢复以后,归档能否一边接收新增数据、一边清掉旧积压。这两项没有答案,扩盘只能延后下一次停机。
归档断了八小时,新增空间怎样被吃掉
PostgreSQL官方连续归档文档明确说明,归档故障持续时,pg_wal目录会继续积累段文件;所在文件系统满了,数据库会发生PANIC关闭,并在释放空间前保持离线。文档所说的已提交事务不会因此丢失,指的是这一关闭情形,不能延伸成对磁盘损坏、误删日志或远端副本完整性的保证。[1]
假设某业务在高峰期间每小时产生3GiB需要归档的WAL,发生故障前可供这项积压使用的空间为60GiB,且暂时忽略其他空间增长。按固定速率推算,60除以3等于20小时。这是一个容量耗尽的假设时间,不是商家机器的实测成绩。系统日志、临时排序文件、表增长与软件更新都会继续用盘,实际处置窗口通常比这份单项预算更短。
再假设归档目的地中断八小时,待发送的积压为24GiB。如果给其他增长和处置动作另留10GiB,本轮演算至少要留34GiB空闲。34GiB只是这一组假设下的算例下限,不能直接变成所有数据库的安全阈值。批量导入、索引重建或整点任务可能使WAL速率突然提高,应以自身业务的高峰窗口重新计算。
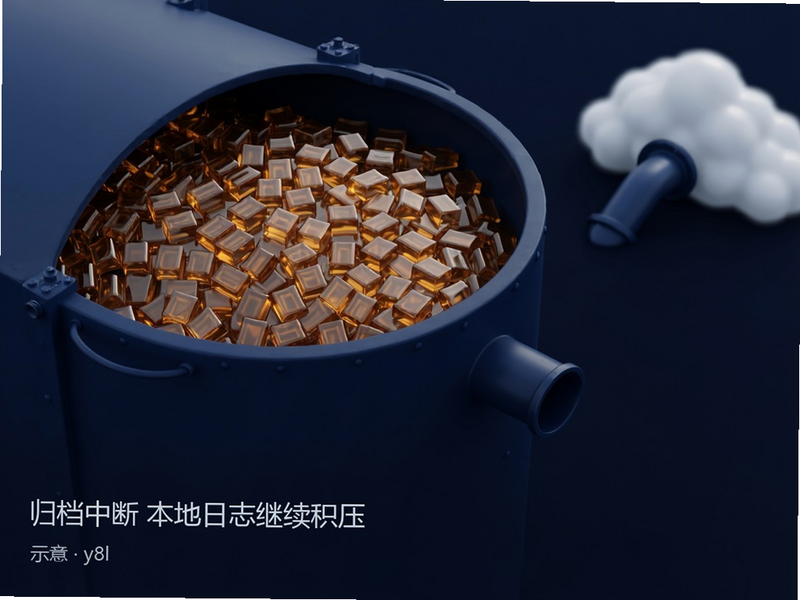
选择更大的盘有明确价值:值班人员多了一段发现和修复时间。但如果报警只发在磁盘剩余百分比很低时,更大的盘也可能让故障隐藏得更久。建议把报警写成“按近期增长速度预计还剩多少小时”,同时保留绝对空闲量阈值;低流量期间的平均值不能替代夜间批处理期间的增长速率。
max_wal_size管不住归档故障的最终体积
把max_wal_size调小,看起来比升级VPS更便宜,却容易解决错问题。官方配置文档把它定义为自动检查点期间WAL增长的软限制,并明确列举重负载、归档命令或归档库失败等情况下可以超过该值。[2] 它不等于文件系统配额,也不会承诺在到达某个大小后安全删除所有尚未归档的段文件。
因此,采购表里写了足够的总容量,仍要核对数据库所在卷的实际可用空间。系统盘和数据盘如果共享同一文件系统,应用日志能挤占数据库的故障余量;分成两个文件系统可以分隔部分容量风险,却不能自动消除同一底层设备的性能争用。独立挂载也要落实权限、开机挂载和故障后的恢复步骤,不能只在架构图里画出两块盘。
WAL长期保留还可能与复制保留策略有关,看到pg_wal很大时,应结合本机配置和复制状态查明原因。不要为了腾空间直接删除尚未确认用途的WAL文件。本稿讨论的是归档积压,不能据此把所有增长都归因于归档,更不能在未识别保留依赖时套用清理命令。运维方案需要明确谁有权限判断和处理,否则增加的容量最终会变成一次更晚发生的人工事故。
恢复连通以后,出口必须有余力追赶
只验证归档目的地重新可达还不够。继续使用前面的假设:积压为24GiB,归档链路在实际小文件、校验与远端写入条件下,每小时能够完成9GiB归档,业务仍每小时产生3GiB。净消化速率是每小时6GiB,清完积压需要4小时;如果出口只能完成每小时3GiB,积压就不会下降。这些数值只是机制推演,不代表SpartanHost的带宽、存储或归档表现。
官方文档要求归档速度能跟上服务器生成WAL的平均速度,也提醒显著落后会增加本地待归档文件。[1] 采购验收应进一步考虑故障后的追赶阶段:平时刚好收支相抵的链路,无法为一次中断提供恢复余力。看订单端口标称速度不能直接得到有效归档吞吐,远端写入延迟、跨区丢包、加密处理和大量文件操作都需要进入同一段实际作业。
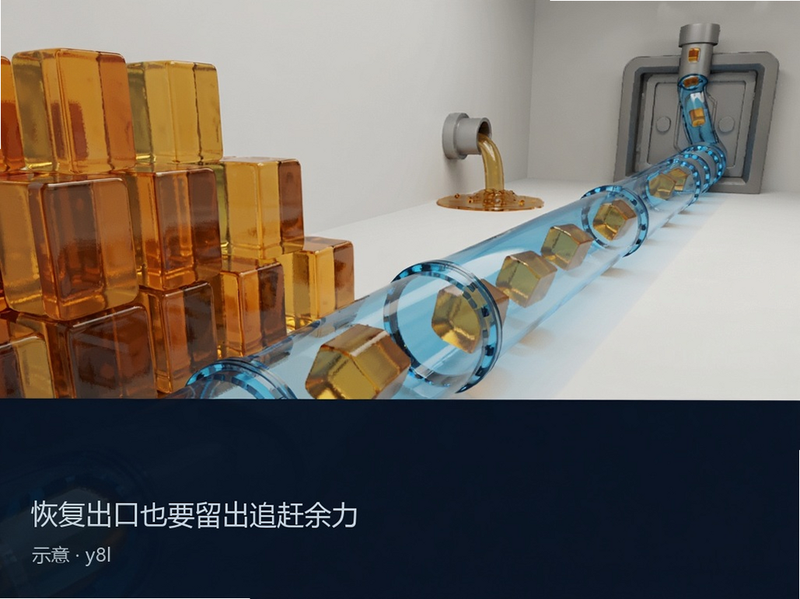
测试环境可以先记录一段正常业务的WAL产生量,再以受控方式中断归档目的地的访问,验证报警是否及时、空闲空间如何变化以及恢复后积压能否下降。演练必须预设停止条件和足够余量,不要在生产数据库上故意等到盘满。备份目的地恢复了访问权限,也应确认日志真正归档成功,而非脚本提前返回成功状态。
成功次数要和失败、滞后及空闲量一起读
pg_stat_archiver提供归档成功次数、最后成功归档文件及时间、失败次数和最后失败时间等信息。[3] 这些数据有助于确认故障发生在哪段时间,却不能单凭累计成功次数增加就判定所有历史段已齐全。观察时要记录统计重置时间,并把最近的失败变化、待归档积压与文件系统余量并排看;如果采样间隔跨过重启或统计重置,简单相减可能给出错误趋势。
归档延迟也要结合业务活动解释。低写入期间,最后成功时间较早不必然表示正在失败;持续写入而积压增长则更值得追查。报警最好同时说明业务是否在生成新WAL、归档是否有新成功、空闲量还能维持多久,让接手人员能选择修复凭据、扩容目的地或调整传输,而不是收到一句没有处置方向的“磁盘不足”。
把SpartanHost订单放进故障预算,再谈付款周期
本次渠道通网站17资料提供了SpartanHost的VPS与服务器推广入口。渠道简介属于采集资料,不是本次订单的配置保证。抓取过程中spartanhost.net请求超时,spartanhost.org主页文字可以读取,但没有取得可用的完整产品画面;因此本稿使用明确标注的生成示意插图。当前售价、库存、磁盘类型、可否扩盘、流量额度和退款条件均未完成订单核验,不能据此宣称有特价或保证某个性能档位。
准备询价时,可以经由SpartanHost服务器与VPS推广入口,核对可用磁盘和扩容条件查看候选订单。此链接具有推广关系。需要向销售确认的是实际交付卷的容量与扩展步骤、扩容是否要停机、账期与续费条件,以及故障时由谁接手数据库之外的系统操作;官网的通用托管描述不能替代这些书面条件。
总成本还应包括远端归档存储、传输费用、保留周期、监控与恢复演练工时。多买本地容量,购买的是暂存和处置时间;增加远端归档能力,购买的是持续接收与追赶能力。两者应按本地增长曲线和中断容忍时间配合,不能把一次扩盘当成整套恢复方案。官方连续归档文档还说明,恢复依赖基础备份及相应WAL序列,单独堆放一批日志文件不能替代可恢复的备份链。[1]
如果演练证明归档故障能在预留窗口内修复,恢复后的出口也能稳定消化积压,现有容量可能已足够,升级整机未必划算。相反,如果正常状态下积压仍持续增长,先修复出口或归档流程,新增磁盘才能成为可计算的缓冲。付款前要求展示这一段故障与追赶记录,比只比较两档磁盘相差多少GB更接近数据库真正需要的交付条件。
资料来源
[1] https://www.postgresql.org/docs/current/continuous-archiving.html , archive
[2] https://www.postgresql.org/docs/current/runtime-config-wal.html , wal
[3] https://www.postgresql.org/docs/current/monitoring-stats.html , monitor
用户评论